Archiv: SEO/SEM

Yahoo 1337 - Leet Backlinks

6 December 2010

Manchmal kann man bestimmte Assoziationen einfach nicht verhindern. Als Computer-Kind bedeutet die 1337 etwas besonderes (siehe auch Leetspeak) und so schmunzelte ich doch sehr als die Webanalyse Software Piwik mir folgende Backlink Statistik präsentierte:

Piwik ist übrigens eine interessante Alternative zu Google Analytics, es handelt sich um eine kostenlose OpenSource Software, die mittels JavaScript, PHP und MySQL Webseitenstatistiken erzeugt. Bei großen Projekten wird die Last auf der Datenbank allerdings deutlich spürbar - vielleicht ist eine relationale Datenbank für Webanalyse eben nicht so gut, wie BigTable (Google) oder andere NoSQL Systeme. Im Gegensatz zu Google Analytics liefert Piwik jedoch auch eine Backlink, Pagerank und Alexa Analyse direkt dazu.

Google Adsense Oktober Update 2010

5 December 2010

Da hat Google mal wieder gearbeitet - und irgendetwas kaputt gemacht. Im Oktober gab es offensichtlich ein Update bei Google Adsense, dass sich fatal auf die Auslieferung von Werbung auf Webseiten auswirken kann. Es wird keine passende Werbung gefunden. Und das, obwohl in der Google Suche eingegebene Keywords aus dem Inhalt der Webseite sehr wohl weiterhin sehr viele Adwords aufzeigen.

Natürlich habe ich versucht den Google  Adsense Support zu kontaktieren - war das früher schon schwer, scheint es mittlerweile unmöglich. (Vielleicht hat Google zu viele gute Mitarbeiter an Facebook abgegeben?)

Mit dem neuen Google Adsense Interface kann man sehr schön sehen, wie die Abdeckungsrate mit passender Werbung schlagartig einbricht: (Adblock User können hier klicken um das Bild zu sehen)

Sollte jemand gute Tipps haben, ich bin interessiert! (Und Google helfe ich natürlich auch gerne, sollte dort Interesse an einer Lösung bestehen.)

Rivva - genehmigt.

18 May 2010

Normalerweise bin ich recht argwöhnisch was Crawler, Bots und derlei Zeugs angeht. So auch, als ich den Rivva Crawler in meinen Logs auftauchen sah: 178.63.0.67 - - [17/May/2010:13:10:46 +0200] "HEAD ... HTTP/1.1" 200 - "-" "Mozilla/5.0 (compatible; Rivva; http://rivva.de)" 0 everflux.de
178.63.0.67 - - [17/May/2010:13:13:19 +0200] "GET ....  HTTP/1.1" 200 29570 "-" "Mozilla/5.0 (compatible; Rivva; http://rivva.de)" 0 everflux.de

Vor dem Sperren schaue ich mir in der Regel die betreffende Webseite an - in der Regel ist das dann eine "neue Suchmaschine" die mit SEO Mitteln versucht Adsense und dergleichen unters Volk zu jubeln, jedoch keinen oder geringen Nutzen bringt. Rivva sah dabei nicht schlecht aus, die About Seite klärte auf,  - und nach dem Blick auf den Namen des Autors war das grüne Licht dann an.

Noch besser wäre das Gefuehl natuerlich, wenn wirklich nur der Feed - und vielleicht auch das eine oder andere Mal die robots.txt abgerufen wuerde, statt die ganzen Seiten. Vielleicht hab ich das aber auch falsch verstanden.

Ein interessantes Projekt in jedem Fall, ich bin gespannt was daraus wird. Und ich werde in in den nächsten Wochen öfters mal drauf schauen auf den Fluss des Internets: rivva.de

Google: Langsam, langsamer, toooo slow

17 May 2010

Google legt neuerdings Wert darauf, dass Webseiten schnell sind. Zumindest hat Google die Ladezeit von Webseiten neuerdings als (einen) Rankingfaktor offiziell bekannt gegeben. In den Google Webmaster Tools ist eine Ladezeit von ca. 2 Sekunden noch im "grünen" Bereich.
Nachdem mir eben aufgefallen ist, dass Firefox Google besonders langsam war, konnte ich mir ein kleines Grinsen nicht verkneifen, als ich dann von Google selbst gesagt bekam, dass nicht mein Browser, sondern wirklich Google langsam war. Und ich meine langsam: Sagenhafte 12 Sekunden fuer eine relativ simple Suchabfrage.

Selbst nachdem ich die selbe Abfrage nochmals verwendete - hier darf man ja aller spätestens einen warmen Cache annehmen - kam das Resultat erst nach 3-4 Sekunden. Wer es nicht glaubt, ich habe echte Screenshots!

SEO fail: Köln Messe "dringend anpassen zur SEO"

26 January 2009

SEO ist zumindest in den Grundzügen nicht schwer: Doppelte Inhalte vermeiden, aussagekräftige Titel, Beschreibung (meta description) und sauberes HTML sind oft schon ausreichend, um eine Seite für Suchmaschinen zugänglich zu machen.

SEO ist also weniger eine technische als auch eine durch den Inhaltsersteller zu betreibende Disziplin - was sich im Negativen durch keywordlastige Überschriften, die mehr für Maschinen als die Leser gebastelt sind zeigen kann.

VirtualBox: Kostenloser Virtualisierer mit neuen Features

22 December 2008

Sun Microsystems hat eine neue Version der kostenlosen Virtualisierungslösung VirtualBox (Sun xVM) herausgebracht. Das neue VirtualBox 2.1 wartet mit einigen Neuerungen auf (changes)

Am interessantesten dürfte dabei sein, dass 64bit Gäste in einer 32Bit Hostumgebung unterstützt werden, erste Schritte in Richtung hardware 3d Beschleunigung gemacht wurden, und verbesserter Support für die Netzwerkanbindung. (Das sollte dem etwas anstrengenden Gefummel mit Netzwerk-Bridges ein Ende bereiten - doch auch NAT soll wesentlich beschleunigt worden sein.)

VirtualBox kann nun auch mit Images von Vmware (VMDK, VHD) direkt arbeiten und unterstützt dabei auch die Snapshot Funktionalität. Weiterhin ist eine Enterprise Version und eine OpenSource Version kostenlos verfügbar.

209.85.238.11 - Google Inkognito?

17 November 2008

Eine IP hats in den letzten Tagen auf sich: 209.85.238.11 - kein reverse DNS Eintrag, deswegen kann er in den Statistiken auch nicht mit irgendwas assoziiert oder zusammengefaßt werden.

Doch wer mag dahinter stecken? Ein Crawler? Ein Blick in die Zugriffslogs gibt natürlich etwas Aufschluß:

209.85.238.11 - - [17/Nov/2008:12:45:49 +0100] "GET /feed/ HTTP/1.1" 200 4856 "-" "Feedfetcher-Google; (+http://www.google.com/feedfetcher.html;

Auch eine Google Suche nach der entsprechenden IP erweckt den Anschein, dass darüber Google sucht ("your ip: 209.85.238.11" in den Suchergebnissen ist recht eindeutig). Letzte Sicherheit schafft dann eine Abfrage wem das zugehörige Subnetz zugeteilt ist:

NetRange:   209.85.128.0 - 209.85.255.255
CIDR:       209.85.128.0/17
NetName:    GOOGLE

Schade, dass Google hier nicht entsprechend der eigenen Hinweise handelt, die zum Verifizieren des Google Bots dienen. Und allem Anschein nach, ist es zum einen nicht nur der Feedfetcher - zum anderen, warum sollte das einen Unterschied machen?

Ach ich glaub ich mail da mal hin.

htaccess Trick um Bereiche für Suchmaschinen zu sperren

7 October 2008

Suchmaschinen - vor allem Google - können sehr hartnäckig sein. Gerade was alte Seiten oder Forumsbeiträge angeht, möchte man diese vielleicht aus Suchmaschinen ausnehmen.

Für Ressourcen, die nicht mehr verfügbar sind, gibt es ab HTTP 1.1 den Status Code 410 (Gone). Mit diesem Wissen gewappnet läßt sich eine Suchmaschine gut steuern.

Im Beispiel handelt es sich um ein Forum, in dem unerwünschte Beiträge nicht gelöscht werden sollen, sondern in einen Bereich verschoben werden, der öffentlich nicht verfügbar ist. (Das Forum ist PHPBB3 - hier kann leider nicht zwischen "eigentlich gelöscht" und in einem Beitrag nur für bestimmte Benutzer unterschieden werden.)

Kennt man die alte URL des Beitrags, so ist dieser zwar nicht mehr verfügbar, aber es erscheint eine "bitte melden Sie sich an" Seite. Nicht gerade das, was man sich wünscht um diesen Beitrag schnell aus dem Google Index verschwinden zu lassen.

Also kommt nun die Apache htaccess hinzu - leider geben sich Suchmaschinen gerne als HTTP 1.0 Browser aus, "echte" HTTP 1.0 Browser verstehen den HTTP Statuscode 410 jedoch nicht. Also kommt noch ein htaccess Trick hinzu: Ein HTTP 1.1 Browser nur kennt den "Host" Header, damit läßt sich eine hinreichende Differenzierung erreichen.

Zu guter letzt möchte man noch den Administratoren ermöglich in dem Bereich Beiträge zu sehen - hier gehe ich einfach mal davon aus, dass sich keine vernünftige Suchmaschine als "Firefox" User ausgeben würde, und die Administratoren seinerseits Firefox verwenden.

Zusammengebaut sieht das dann so aus: #exclude archive pages from search engines, if http 1.1 capable (using host header check)
RewriteCond %{HTTP_HOST} .
#not for humans
RewriteCond %{HTTP_USER_AGENT} !Firefox [NC]
#else: gone
RewriteRule ^archiv/ - [G,L]

Eurobot 1.0: Ayell Euronet Crawler

14 July 2008

Ayell crawlt seit ein paar Tagen in meinem Blog rum. Offenbar versucht jeder inzwischen ein klein-google nachzubauen. Dazu verwendet Ayell Euronet immerhin einen Crawler, der sich vernünftig zu verhalten scheint.

Adsense Rückwärtssuche von Adfire (adshadow)

6 July 2008

Wie Jojo (This-and-that) berichtet, gibt es ein neues Tool: Quasi eine Adsense Rückwärtssuche. Das ganze funktioniert so: Auf adshadow.de gibt man eine Adsense ID oder eine Webseiten URL an.

Dann kann man sich eine Liste aller anderen Webseiten anschauen, auf denen diese Adsense Publisher ID auftaucht. (Man kann davon ausgehen, dass Google etwas ähnliches zur Hand hat ;-) ) Vielleicht für den einen oder anderen "nicht so schön", und gefragt hat auch keiner.

Google: Einblick in die Konkurrenz

22 June 2008

Google hat ein neues Produkt online. Beta, wie üblich. Diesmal werden "anonymisierte" Daten über Webseiten via Google Trends veröffentlicht.

Das erlaubt einem schon ganz gute Einblicke in den Markt. Auch gibt es einen kleinen Einblick in die Möglichkeiten, die Google oder andere Datensammler mit den erhobenen Daten bekommen.

Nachdenklich sollte Google Trends for Websites auch im Hinblick auf die Voratsdatenspeicherung machen: An viele Möglichkeiten der Auswertung denkt man zum Zeitpunkt der Erhebung nicht. Das gilt auch für "loyalty" Programme wir Miles and More oder Payback. Den üblichen Verweis auf Orwell erspare ich mir.

Hier die - wenigen - Daten zu diesem Blog: everflux.de Trends

Etwas aufschlußreicher ist ein Blick auf mein allseits geliebtes Lawblog: lawblog.de Trends Der typische Lawblog Leser ist also ein grüner Taxi-interessierter der sich neben Rechtsthemen aber auch für andere top-blogs interessiert.

Nimmt man dann noch hinzu, dass Google bemüht ist, Suchabfragen einen "Sinn" zu geben (Google erkennt schwule und lesben), kann einem Angst und Bange werden.

Slurp 3.0 - Yahoo hat neuen Crawler

15 April 2008

Yahoo hat die Crawler Infrastruktur aktualisiert - teil davon ist Slurp 3.0, der neue Yahoo Crawler. Wie Golem berichtet hat Yahoo bisher nicht veröffentlicht, welche Aktualisierungen an dem Crawler vorgenommen wurden.

Dies ist kein unübliches Vorgehen, lediglich als Google seinen Crawler beigebracht hat, gzip Inhalte zu verstehen, oder die Crawler an einen gemeinsamen Cache angeschlossen hatte, um doppeltes Crawlen zu vermeiden, wurde dies publik gemacht. Bei Yahoo steht eine Umstellung auf Hadoop an - die Zukunft lautet bei Yahoo immer stärker OpenSource und Java. Sicherlich nicht schlecht für die Community, zudem zeigt es deutlich, dass Java alles andere als "langsam" ist. Nachdem Yahoo auf einigen Seiten für 20% und mehr des Traffiks verantwortlich war, da der Crawler wild auf content war, könnte dieses unerwünschte Phänomen mit dem Slurp 3.0 nun der Vergangenheit angehören.

Referrer Spam - von Google?

18 February 2008

Google, der Mr. "Don't be/do evil" macht jetzt Referrer-Spam, um Cloaker zu enttarnen. Ist schon länger bekannt - aber was es hiermit aufsich hat, das ist mir noch etwas unklar:
Der Versuch heute webalizer oder webdruid Statistiken vernünftig zu lesen wurde hinfällig, denn hunderte Requests dieser Sorte machen die Auswertung von Suchanfragen per Referrer kaputt:

Warum ich Newskraft sperre

10 January 2008

Für alle die eine "Suchmaschine" bauen - es gibt ein paar klitzekleine Verhaltensregeln, die man beachten sollte.
Ein Beispiel:


78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /feed/ HTTP/1.1" 200 15773 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /feed/rss/ HTTP/1.1" 200 9052 "http://www.newskraft.de" "Newskraft.de" 1 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /feed/atom/ HTTP/1.1" 200 15021 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /?p=470&akst_action=share-this HTTP/1.1" 200 4908 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /?p=469&akst_action=share-this HTTP/1.1" 200 5049 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /?p=468&akst_action=share-this HTTP/1.1" 200 4644 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:46 +0100] "GET /?p=467&akst_action=share-this HTTP/1.1" 200 4828 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:47 +0100] "GET /?p=465&akst_action=share-this HTTP/1.1" 200 6963 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:47 +0100] "GET /?p=464&akst_action=share-this HTTP/1.1" 200 5003 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:47 +0100] "GET /?p=462&akst_action=share-this HTTP/1.1" 200 4847 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:47 +0100] "GET /?p=461&akst_action=share-this HTTP/1.1" 200 7506 "http://www.newskraft.de" "Newskraft.de" 0 everflux.de
78.46.45.99 - - [10/Jan/2008:21:28:47 +0100] "GET /?p=463&akst_action=share-this HTTP/1.1" 200 9277 "http://www.newskraft.de" "Newskraft.de" 1 everflux.de

Man beachte die Zeiten, wann die Zugriffe stattfanden.
Und das war noch lange nicht das Ende. Also wenns denn schon ein Crawler sein soll, dann nicht mehr als einen Zugriff pro Sekunde.
Immerhin bei Newskraft lobenswert: robots.txt wird vorher geladen - wie sie genutzt wird, hab ich jedoch nicht ausprobieren wollen.

Google gibt Feedstatistiken im User-Agent an

10 January 2008

Normalerweise schaue ich nicht in die live Logs vom Apache Webserver des Blogs, aber aus gewissen Gründen machte ich mir doch mal die Mühe.
Was mir da gerade über den Weg gelaufen ist, finde ich doch interessant:

"Feedfetcher-Google; (+http://www.google.com/feedfetcher.html; 1 subscribers; feed-id=18021914886172537744)"

Viellicht gehört das nicht unbedingt in den Useragent - aber in jedem Fall eine sehr innovative Idee.
Da muß ich nichtmal Feedburner oder ähnliches bemühen um herauszufinden dass ich einen ganzen Leser habe ;-)
Was ich nicht ganz verstehe, sind die weiteren Requests, die eine andere Feed-Id beeinhalten.

"Feedfetcher-Google; (+http://www.google.com/feedfetcher.html; 1 subscribers; feed-id=16484629274111537011)"


Aha, die antwort ist einfach: Wenn Google den Feed über verschiedene URLs kennt, so wird jedesmal eine eindeutige 64bit ID pro URL erzeugt.
Das bedeutet, man muss die Anzahl der Abbonennten zusammenzählen. Dann hab ich wohl 2. :-)
Weitere Informationen zum Google Feedfetcher gibt es im Google Reader Help Bereich.

seo-phpbb.org bald wieder online

6 January 2008

Tobi, der das seo-phpbb Projekt betreibt, ist zuversichtlich bald wieder mit der Seite online zu gehen.
Derzeit finden sich die Downloads lediglich bei Google-Code.
Besonders schön, wenn die Seite wieder online ist, gibt es auch wieder die Banner-Management und weitere Plugins, die Tobi entwickelt. Hut ab vor dem Projekt!

Wer überlegt ein PhpBB2 oder PhpBB3 zu betreiben, sollte sich unbedingt die SEO Modifikationen ansehen. Insbesondere für stark frequentierte Foren sollte PhpBB3 dank Caching den Server deutlich entlasten, und ist eine oeberlegung für derzeitige phpbb2 Foren wert.

Google Content Analyse per Webmaster Tools

14 December 2007

Vermutlich kennt jeder schon die Google Webmaster Tools. Und fast jeder die neuen Funktionen der Content Analyse der Google Webmaster Tools.
Ich kann die bis heute noch nicht - war ich doch lange nicht mehr in den Webmaster Tools unterwegs. Sehr schöne neue Funktionen, wie ich finde:

  • Probleme mit title Tags von Webseiten (was auch immer hier käme, ich habe keine Probleme gemeldet :) )
  • Doppelte Meta Beschreibungen (könnte mal für duplicate content gehalten werden, zumindest wird Google hier aber eher ein Text-Snippet in den Suchergebnisseiten (SERP) anzeigen als die Meta Description
  • Lange Metabeschreibungen - auch hier gilt: Eher ein Snippet als eine viel zu lange Metabeschreibung. In der kürze liegt die Würze!
  • Kurze Metabeschreibungen - diese sind dann zu kurz. Nur drei oder vier Worte - das hilft auch keinem Surfer. Also auch hier wieder eher ein Snippet als die ggf. gewünschte META Description in den Suchergebnisseiten

Warum aber sind Title und Description denn so wichtig? Ganz einfach: Selbst wenn man bei Google für ein Ergebnis sehr weit oben ist (also Seite 1 und da ggf. noch "oben") heißt es nicht, dass der User auch klickt.
Ich z.B. klicke aus Prinzip nicht auf diese extrem häßlichen Ergebnisse von cylex dem "Stadtbranchenbuch". Die sind stets in Großbuchstaben und die Beschreibung (sic!) lädt nicht zum klicken ein.
Wenn ich anhand der Beschreibung aber schon abschätzen kann - hey die Seite ist relevant (und das macht Google auch im Vorfeld) bzw. interessant, dann klicke ich.
Und so geht es anderen auch.

Preiswerte Suchmaschinenoptimierung .de

2 December 2007

Ich bin ja ein ganz großer Fan davon, wenn mir Dienstleistungen oder Artikel per E-Mail angepriesen werden. Hier haben wir es mit einem besonders seriösen Angebot zu tun, dass ich keinem vorenthalten möchte.
Vorweg die Gründe, weswegen man aus meiner Sicht solche Angebot auf gar keinen Fall annehmen sollte:


  • Firma ist eine britische Ltd. - muss ich wohl nicht mehr zu sagen

  • Produkt wird per Spam Mail beworben

  • Opt-Out wenn man keine weiteren "Informationen" möchte

  • 105 Backlinks? Alle großen Suchmaschinen (wie Google) haben Richtlinien die genau solche "unechten" Links verbieten

  • Unrichtige Behauptungen in den Aussagen

  • "Sie zahlen nur für TOP Positionierungen"


Jetzt aber zu der Offerte von preiswerte Suchmaschinenoptimierung.de

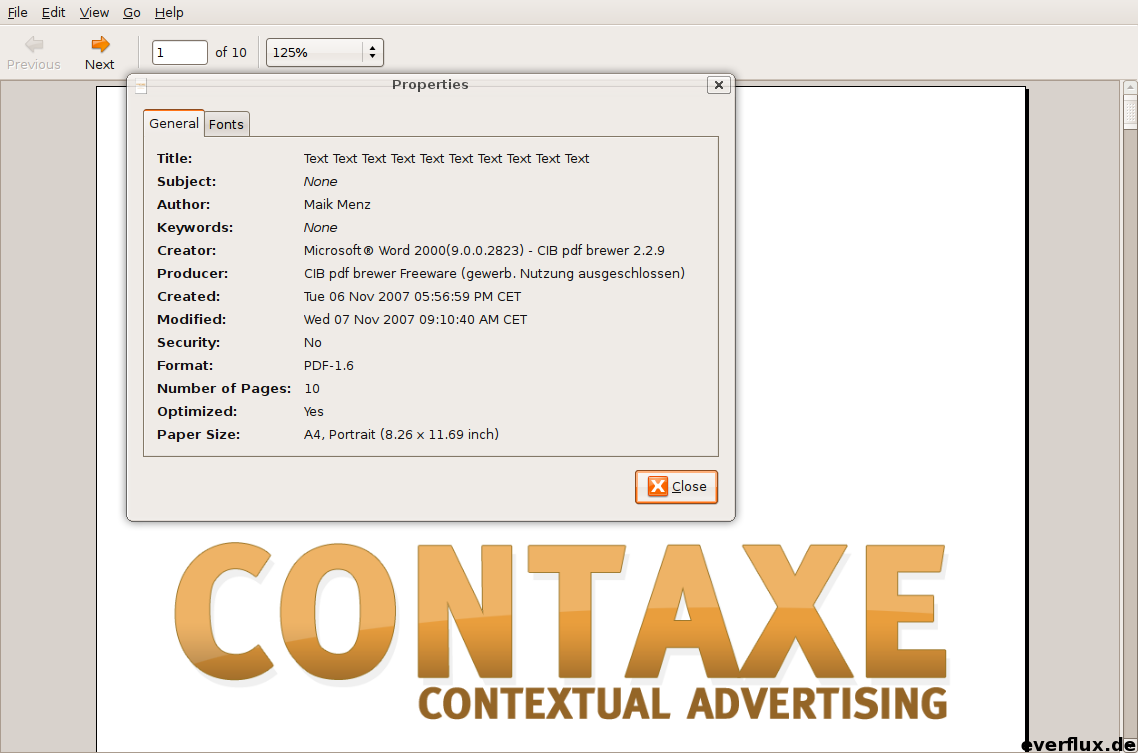
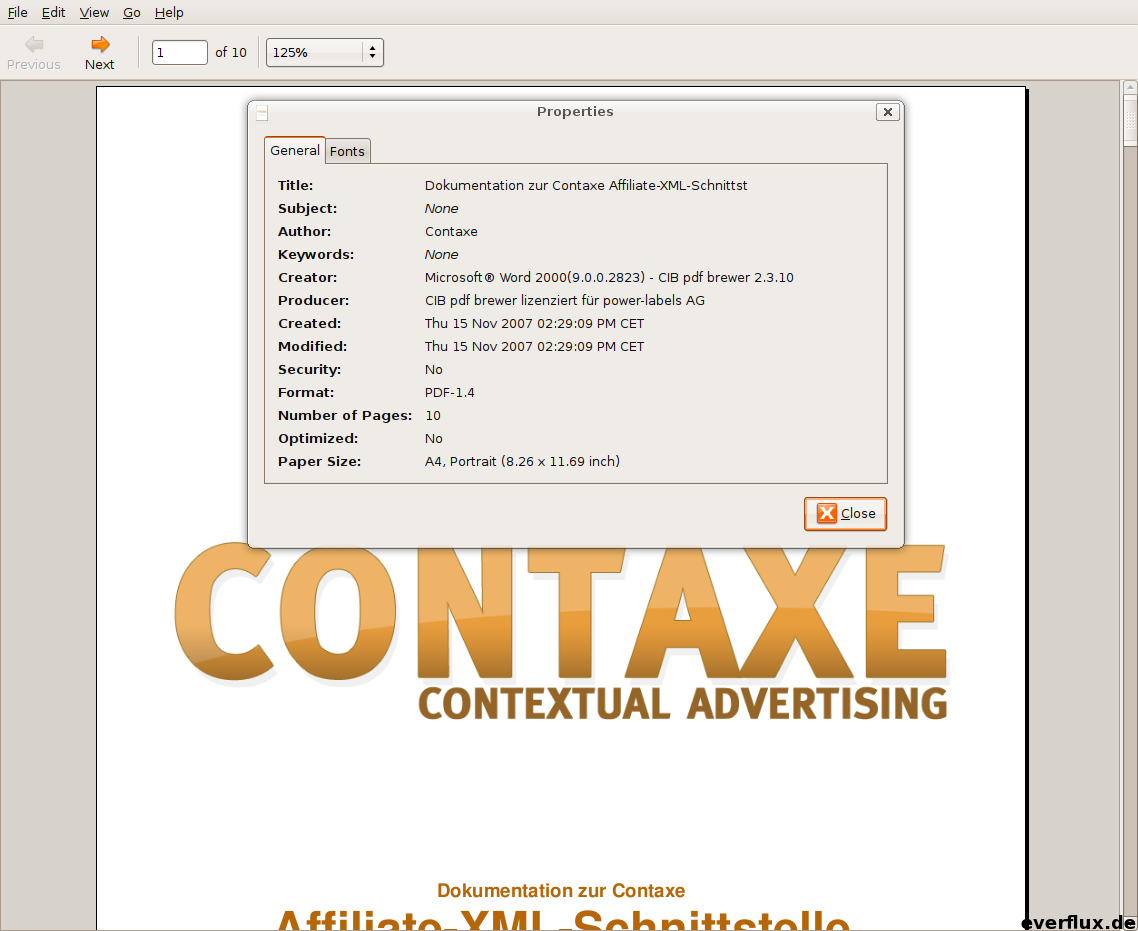
Contaxe: Vorher nachher

15 November 2007

Wer sieht den Unterschied?


War Office 2000 nicht die letzte Version, die nicht online freigeschaltet werden mußte?

(PS: Der CIB PDF Brewer kostet für gewerblichen Einsatz 19 Euro. Richtig, nichtmal einen zwanni. Jeder kann sich ja selber überlegen wie seriös er sowas findet.)

209.249.11.3 - Microsoft Research MSRBOT

6 November 2007

Noch weit mehr als Google-Bot und der Yahoo Slurp Crawler zusammen hat der Host 209.249.11.3 bei mir Traffik gemacht. In den Statistiken habe ich erstmal nur die Traffiksumme gesehen und mich gefragt: Wer zum Henker...
Das Netz ist von Abovenet als Microsoft Research Subnetz mit 14 Hosts announced. Immerhin identifiziert sich der Bot auch im Useragent vernünftig:
209.249.11.3 - - [02/Nov/2007:23:31:36 +0100] "GET /resharper-jetbrains-bringt-resharper-30-fur-visualstudio-231/ HTTP/1.0" 200 14213 "/category/microsoft/" "MSRBOT (http://research.microsoft.com/research/sv/msrbot/" 0 everflux.de

Ich finde es schön, dass Microsoft forscht - ich sehne ein Such-Oligopol herbei, und noch vor Yahoo sehe ich bei Microsoft ein großes Potential. Was an dem Bot interessant ist: Er übermittelt ein Referrer! Damit könnte man sich einen interessanten Einblick verschaffen, wie der Bot crawlt. So haben alle was zum Forschen...

Adsense Sperre wegen G..gle in der URL

26 October 2007

Wie Google Bogoscoped berichtet wurde eine Webseite von Adsense ausgeschlossen weil das Wort Google in der URL vorkommt.
Das kann erhebliche Auswirkungen für diejenigen haben, die standardmäßig den Titel eines Artikels auch als Path Anteil der URL, die zu dem Artikel führt, verwenden.
Dies wird inzwischen in vielen Foren, Newssystemen und Blogs gemacht, da die URL damit schöner aussieht und auch für Suchmaschinen einen Hinweis gibt, um welches Thema es in dem durch die URL referenzierten Inhalte geht.

Contaxe Crawler

24 October 2007

Wer den Contaxe Crawler identifizieren möchte, der kann es mit den folgenden Angaben versuchen (ohne Gewähr!).
Bei mir kommt der Crawler von der IP 217.24.217.120.
Der Contaxe Crawler hat bei mir folgenden UserAgent: "contaxe.com"
Sehr positiv fällt auf dass der Contaxe Spider offenbar gzip Kompression unterstützt - das spart Bandbreite.

Contaxe Erfahrungen

23 October 2007

Contaxe ist Mitte 2007 als neuer Anbieter kontextueller Werbung auf den Markt getreten - dabei kam schnell der Eindruck auf, dass Contaxe sich an der quasi Referenz Google Adsense messen muß.
Viele fragen sich seit dem


  • Ist Contaxe eine Adsense Alternative?

  • Wieviel Geld kann ich mit Contaxe verdienen?

  • Wie sind die bisherigen Contaxe Erfahrungen


Amazon Affiliate Bot identifizieren / Zugriff erlauben

10 October 2007

Für alle die sich, wie ich, fragen welchen UserAgent der Amazon Affiliate Bot verwendet:
Mozilla/5.0 (compatible; AMZNKAssocBot/4.0)
Der Bot wird von Amazon z.B. eingesetzt wenn man Kontext-Werbung für das Amazon Affiliate Programm einbindet. (Z.B. durch die Amazon Links, oder die Amazon Kontext-Banner)

Der UserAgent kann verwendet werden, um den Bot auf normalerweise geschützte Seiten zu lassen oder eine optimierte Version der Seite auszuliefern.
Man sollte dabei bedenken, dass man den UserAgent eines Browsers auch als Benutzer umstellen kann, z.B. sehr komfortabel über ein Firefox Addon. Den Zugriff auf passwortgeschützte Seiten dann nur über den User-Agent für den Amazon Bot freizugeben halte ich für zu kurz gegriffen.
Sicherer ist da sicherlich noch zusätzlich die IP des Bots zu verwenden - bei mir kamen die Zugriffe bisher von der IP
87.238.80.64

Bei der Kombination dürfte man dann relativ sicher gehen, dass auch nur der Bot die Inhalte crawlt.

PhpBB2: Werbung dynamisch hinzufügen - getElementsByClassName

27 September 2007

Wenn man ein phpbb2 Forum hat, und dynamisch etwas Platz für einen Skyscraper Werbebanner schaffen möchte, dabei jedoch nicht alle möglichen Templates umstricken möchte (z.B. um erstmal nur die Einblendungen zu testen), kann man per JavaScript etwas "Platz" schaffen.
Ich gehe vom SubSilver phpbb2 Template aus, dort haben alle Tabellen, die das Forum "aufspannen" den Klassennamen "forumline". (Das ist der dicke Blaue Balken)
Ich wollte nach Möglichkeit Werbemittel erst am ende der HTML Seite einbinden, damit die Ladezeit möglichst nicht beeinträchtigt wird. Daher entschied ich mich dafür, nachträglich erst Platz für werbung zu schaffen - so ist nur ein Template zu bearbeiten und es kann sehr schnell wieder die Werbung entfernt werden.

Jetzt gibt es leider keine DOM Funktionen um alle Elemente mit einem Klassennamen zu erhalten. Daher habe ich mir eine JavaScript Krücke gebaut, die getElementsByClassName simuliert:

<script type="text/javascript"><!--
var pattern= new RegExp("(^|s)"+"forumline"+"(s|$)");
var elements = document.getElementsByTagName("table");
   for (i = 0, j = 0; i < elements.length; i++){
  if(pattern.test(elements[i].className))
  { elements[i].style.paddingLeft = "160px";
 elements[i].style.minHeight = "640px";
     break;  }
}
--></script>
Jetzt haben wir für das erste Element das "forumline" heißt die CSS Styles dynamisch geändert - der Foren "Inhalte" rutscht nach rechts. Platz für einen Skyscryper Banner im Forum - der kann jetzt absolut positioniert werden.

Z.B. so:

<div style="display: none; position: absolute; top: 280px; left: 20px; height: 600px; width: 160px;">
Hier steht ihre Werbung - z.B. Amazon oder Adsense JavaScript.
</div>
Optimal ist diese Lösung nicht - hat aber den Vorteil, dass bei ausgeschaltetem JavaScript eine normale Darstellung ohne klaffende Löcher gewährleistet bleibt.

Amazon context-links als neues Werbemittel

27 September 2007

Amazon hat als beta Produkt Context-Links eingeführt, wie aus dem Amazon Partner blog hervorgeht.
Dabei werden automatisch im Text Worte zu Amazon verlinkt, wenn diese als passend erkannt wurden. Kauft dann jemand über Amazon ein Produkt, bekommt der Affiliate eine Provision gutgeschrieben.
Insgesamt ein interessantes Produkt, da die Context-Links weniger nerven als blitzende Banner oder Content zerhackende andere Werbemittel, wie ich finde.
Ob sich das auch wirtschaftlich lohnt, hängt sicherlich von Content und Zielgruppe ab. Da es keine Pay-Per-Click sondern ein klassisches Affiliate Partnerprogramm ist, ist das angenehme an Amazon Werbeprodukten, dass es sich für Webmaster nicht lohnt durch Designtricks oder andere Maßnahmen die Klickrate (künstlich) zu erhöhen, wie es in letzter Zeit bei vielen Adsense seiten zu sehen ist.
Nicht ohne Grund testet auch Google inzwischen Pay-per-Action Werbemittel, da der Klickbetrug eine immer größere Bedrohung darstellt.
Für Branding Kampagnen eignet sich dies Werbemittel allerdings dann nicht.

Google Deutschland ausgefallen

23 August 2007

Google Ausfall - gibts nicht? Gibts doch!
Diesmal scheint aber nicht eine Domain-rekonnektierung schuld zu sein, sondern ein Netzwerkproblem.

Was das wohl für Seiten bedeutet, die auf Google Traffik angewiesen sind...

 Host                                Loss%   Snt   Last   Avg  Best  Wrst StDev
1. localhost                         0.0%    29    0.5   0.2   0.1   1.4   0.3 2.
217.0.118.43                      0.0%    29   43.0  43.2  42.3  45.3   0.6 3.
87.186.240.230                    0.0%    29   43.4  43.7  42.6  47.8   1.1 4.
f-ea5.F.DE.net.DTAG.DE           20.7%    29   49.2  53.8  48.5  95.0  11.9 5.
62.156.138.94                     0.0%    29   49.0  51.0  48.8  61.5   3.2 6.
???
Update: Auch am 14.5. gab es wieder einen Ausfall von Google Deutschland.

Google Adsense Empfehlungen 2.0: Amango Spam

21 August 2007

Amango ist mir schon öfter durch recht forsches Marketing aufgefallen. Abgesehen davon, dass trotz einer Wunschliste von über hundert Titeln bei einem Freund von mir ewig nichts geliefert werden kann, ist mir persönlich Amango heute negativ aufgefallen.
Bei Google Adsense gibt es jetzt Produktempfehlen - klassisches Affiliate Marketing quasi, wo kein pay per click, sondern pay per action stattfindet. (Kauft der Kunde was über so einen Banner wird ausgezahlt - sonst gibts garnichts!)
Hier versucht sich Amango erstmal in mehreren Kategorien gut zu platzieren und dort auch noch in aller Breite.
Für mich macht das das Google Adsense Erlebnis nicht angenehmer.

Links von der Bundesregierung - das gibt Pagerank!

4 June 2007

Das ist doch mal ein hammer guter Zug: Ich
schnapp mir einfach eine Domain, die mal für ein Projekt der
Bundesregierung gedient hat.

Vielleicht ist es auch nur eine Fehlkonfiguration oder ein Versehen
- man kann ja nie wissen, aber interessant ist es allemal, das
scheinbar genau das hier passiert ist:

http://www.gnupp.de/ der Verweis auf "sicherheit-im-internet", dem Projekt des
Bundesministeriums für Wirtschaft und Arbeit (BMWA) und des
Bundesministeriums des Innern (BMI).
Nur lauscht auf der Domain inzwischen eine Firma, die Sicherheitslösungen anbietet. Und auch Internetdienstleistungen.

Mit Sicherheit gibts noch weitere Links darauf aus den Zeiten als das Projekt aktiv lief.

Google liefert es denn auch als einen der ersten Treffer bei der Anfrage "sicherheit im Internet" - als Snippet erscheint (noch) "Ein Informationsdienst des Wirtschaftsministeriums, des Innenministeriums und des BSI zum Thema 'Sicherheit im Internet' mit aufbereiteten Einführungen, ..." Na denn.

Neues google Feature in der Suche: Notieren

4 June 2007

Das ist ja mal ein heißes Feature :)
Eigentlich wollte ich in dem Feed eines Blogs stöbern und war gerade zu faul die URL in meinen Bookmarks zu suchen. Also schwupps Google aufgemacht und da fällt mir ein neuer Aktionslink ins Auge: Neben "im Cache" und "ähnliche Seiten" kann ich mir jetzt noch "Notieren" anwählen.
Wie kommts dazu?
Ich hatte mich vorher bei Google angemeldet um Analytics Daten anzuschauen. Und somit kann ich von den erweiterten Funktionen der personalisierten Suche profitieren.
Was ein Komfort!

Und das gibts im Tausch für das bißchen Privatsspähre...

Wie, Deine Mutter bloggt???

12 April 2007

"Deine Mutter bloggt?" - ich habe es lange nicht geschafft, Menschen so überrascht zu sehen. Und es waren ehrliche, teilweise schockierte Gesichter, in die ich blickte.
Was hatte ich da nur angerichtet - der SEO Stammtisch in Münster (veranstaltet von seo-factory) war bis dahin ein gemütliches und nettes Grillen gewesen, mir nicht klar in welche Situation ich mich hineinmanövrierte, als das Thema Sudoku angeschnitten wurde und ich sagte "Wow, das wäre ja was für meine Mutter. Muß ich ihr gleich mal erzählen - vielleicht bloggt sie ja darüber".
Offenbar liegt nicht allen Webmastern oder SEOlern die Internet-Affinität in den Genen ;-)
Auch sonst kann ich nur sagen, daß der Abend sehr nett, informativ und amüsant war. Vielleicht nicht zuletzt wegen spontanen Aussagen meinerseits zu Themen wie Singlebörse, "Zeitschriften in neutralen Umschlägen" und anderen Fettnäpfchen.
Natürlich durfte auch die Werbung für die von mir innig geliebten "Webmasters on the roof" nicht fehlen - es gibt echt noch Leute, die den Podcast nicht kennen...

SEO Stammtisch Münster

27 January 2007

Diese Woche war ich zum ersten Mal überhaupt auf einem SEO Treffen - es war der SEO Stammtisch in Münster, der von seofactory.de veranstaltet wurde.

Ich bin durch und durch begeistert, mit Gleichgesinnten Erfahrungen auszutauschen, über Projekte reden zu können und auch den einen oder anderen nötigen Kick in die richtige Richtung zu bekommen ist unbezahlbar.

(Klar, manches kann man sich eigentlich selber denken, aber dann stellt man doch mal eine Frage wie "Wo ist eigentlich der Unterschied zwischen einer Sperre per robots.txt und per noindex" - ganz klar, eine per robots.txt gesperrte URL wird nicht gecrawlt, aber kann dennoch in SERPs auftauchen, wenn sie entsprechend angelinkt wird.)

Auch war es sehr spannend mal die Gesichert hinter all den freundlichen Schreibern aus den verschiedenen Foren kennenzulernen, und vielleicht ergibt sich ja für den einen oder anderen auch geschäftlich die Chance einer Zusammenarbeit. So waren Themen wie "wer kennt einen guten Grafiker" und Erfahrungen mit Texterstellungs-Auftragnehmern ebenso vertreten, wie Optimierungstipps für das oft eingesetzte phpBB2.

Ich freue mich schon auf den nächsten Stammtisch der in ungefähr 2 Monaten stattfinden wird - hoffentlich habe ich bis dahin auch einige der guten Tipps in die Tat umgesetzt.

Google Deutschland entführt

23 January 2007

Relativ spät am Abend fragt mich ein Freund, ob ich Google aufrufen könnte.

Natürlich kann ich.

Er aber nicht. Er schickt mir einen Screenshot. Ich tippe auf DNS, dann auf Routerprobleme. Warum auch immer, www.google.de löst bei ihm zu 82.100.220.170 auf, die Vertipper-Addresse ww.google.de löst garnicht auf, während ich da brav eins der Google-Datacenter bekomme.

Google-Kidnapping

Inzwischen wurde auch woanders darüber gebloggt, und (ich hätte eher drauf kommen sollen) die Erklärung ist wohl ein Domain-Transfer bei der Denic, Mario Micklisch mit der Firma "favo" aus Wiesbaden ist neuer Inhaber.

Das gibt "rger.

Update: 3:28 Uhr. Irgendwer ist bei der Denic aufgestanden, und hat Knöpfchen gedrückt.

Google ist wohl doch wichtig. (Changed:     2007-01-23T02:28:16+01:00), zwar ist der Inhaber gleich geblieben, aber es sind wieder die korrekten Google-Nameserver eingetragen. So einen Support möchte ich auch mal haben. Wundert man sich nur, wie es überhaupt soweit kommen konnte, und was passieren würde, wenn das einer nicht ganz so bedeutenden Firma passieren würde.

Google Adsense: Neue Richtlinien verbieten bestimmtes Layout und Farben

18 January 2007

Google hat im Januar neue Richtlinien für das Adsense Programm bekannt gegeben. Diese beinhalten dabei die Vorgabe, daß Publisher, als die Adsense einbindenden Webseiten, keine anderen Anzeigen oder Services (also Inhalte) anbieten, die die Farben oder das Layout von Google Anzeigen imitieren, ich zitiere:

Um Verwirrung bei den Nutzern zu vermeiden, dürfen Google-Anzeigen oder -Suchfelder nicht auf Websites mit anderen Anzeigen oder Services veröffentlicht werden, die dasselbe Layout und dieselben Farben wie Google-Anzeigen oder -Suchfelder verwenden. Auf Ihrer Website dürfen Sie zwar eigene Anzeigen verkaufen, müssen jedoch dabei sicherstellen, dass diese Anzeigen keinesfalls wie Imitationen von Google-Anzeigen aussehen.

Was bedeutet das nun für einen Adsense Publisher? Was damit "gemeint" ist, ist eigentlich klar: User sollen nicht darauf trainiert werden, auf Anzeigen oder Suchfelder zu klicken, die später durch Adsense ersetzt werden. Auch möchte Google sicherlich seine "Marke" in Form eines möglichen Geschmacksmusters der Adsense/Adwords Layouts und Farben schützen.

Doch wörtlich ausgelegt bedeutet das, daß man keine eigene Suchfunktionalität anbieten darf, keine Inhalte auf der Seite anbieten darf, die ähnlich den Google Anzeigen aussehen. Das ist schon eine ziemlich harte Vorgabe. (Ich habe z.B. auf einer Webseite eine Funktion eingebaut, die die neuesten Beiträge aus unterschiedlichen Bereichen auf allen Seiten in Form von Snippets einblendet, die, je nach Auslegung, dem Layout von Google Anzeigen ähneln.

Damit wäre diese Seite schonmal nicht ohne massive Umbauarbeiten oder das Risiko, von Google aus dem Adsense Programm gekündigt zu werden mit Adsenes kombinierbar. Es bleibt abzuwarten, ob es da noch weitere Klarstellungen geben wird.

Link zu den Programmrichtlinien.

Wordpress Title: "»" verhindern

9 January 2007

Wer sein Wordpress mit einem eigenen Theme/Template versehen möchte, wird sich gefragt haben, wie man es hinbekommt, daß im Title nicht mehr dies » Zeichen auftaucht. Die Ursache ist schnell identifiziert: Wordpress schreibt in den Title » wenn wp_title() aufgerufen wird.

Das ist vor allem für Bookmarks störend, aber auch für die Ergebnislisten von Suchmaschinen (SERP Snippet), da es unattraktiv aussieht.

Die Lösung ist sehr einfach, beim Aufruf von wp_title() kann ein Parameter mitgegeben werden, der den Trenner setzt - gibt man den leeren String als Trenner an, so wird auch keiner ausgeben. Also wp_title(``) statt wp_title() aufrufen und schon sind die Wordpress Title wieder schöner.

Update: Wordpress ersetzt auch gerne mal Anführungsstriche oder die einfachen Hochkommata. Und ich habe auf die schnelle nicht herausgefunden, wie ich diese "Intelligenz" abgedreht bekomme. Also es muß natürlich wp_title( ) heißen, und in der Klammer einfach direkt hintereinander zweimal Anführungsstriche.

Google Adsense: Google-Adsense-Blog Spam

25 December 2006

Inside Adsense ist das englische, von Google betriebene, Blog zum Thema Google Adsense. Die Idee dabei ist, Neuigkeiten den Publishern (denjenigen, die Adsense auf ihren Webseiten einsetzen) zu kommunizieren, aber auch Tipps und Hilfestellungen zu geben.

Dabei wird die Google gehörende Blogspot Plattform genutzt, die in der Vergangenheit bereits im Zusammenhang mit Sicherheitsproblemen, insbesondere bei den Google-Blogs aufgefallen ist.

Eben ist mir dann bei diesem Artikel etwas interessantes aufgefallen: Google linkt auf Spam-Seiten, und dabei ohne das von Google selbst eingeführte rel="nofollow" bzw. rel="external" Attribut im Anchor-Tag zu verwenden. Na da wird sich mindestens ein Spammer richtig freuen.

Google linkt auf spammer

Wer nicht glaubt, daß es sich um einen Spammer handelt, hier noch der Quelltextausschnitt:

<dt> span style="background-image:
url(http://www.blogger.com/img/triangle_open.gif);"
class="comment-toggler"> &nbsp;</span> <a 
href="http://adsensewebpages.com/archive/Colors-Adsense/2862/">
Recipes for Google Adsense Ads !</a>

Ich denke, Google sollte sich kräftig beeilen, der Webspam-Geschichten Herr zu werden, statt selber noch soetwas zu unterstützen.

UPDATE: Wie ich von Fridaynite erfahren habe, war ich nachlässig bei der Kontrolle der Angelegenheit, denn tatsächlich "gibt" es den angeprangerten Link garnicht. Den gibt es erst, nachdem Blogger per JavaScript an der HTML Seite quasi nachträglich rumgefummelt und den Link dort eingebunden hat. Für Suchmaschinen unsichtbar. (Also ist es quasi "nur" Spam der höchstens Benutzer stört, die, wie ich, auf den Link klicken)

Dabei hat mir Firefox einen Streich gespielt: Ich habe das Webdeveloper-Plugin installiert, und dort gibts dann die praktische Funktion einen Teil der Seite zu markieren und sich den Quelltext ("View selection source") anzusehen - was angezeigt wird, ist dabei der Quelltext "zur Laufzeit", also nicht wie er vom Webserver ausgeliefert wird, sondern was nach allen JavaScript und Ajax Hexereien daraus geworden ist.

Man lernt nie aus.

Google: Spam und Gegenspam

4 December 2006

Nachdem es einigen Wirbel um das De-Listing einer Webseite gab (Slashdot, Digg, ...) hat sich Google in Form von Matt Cutts dazu geäußert, wie Google mit spammigen und gehackten Webseiten umgeht:

Dabei kam heraus, daß Google automatisch E-Mail versendet, wenn die Maschine der Ansicht ist, daß der Spam auf den Webseiten "versehentlich" oder durch einen Einbruch verursacht wurde, nicht jedoch, wenn davon ausgegangen werden muß, daß ein black-hat SEO am werkeln ist.

Der Webmaster der betroffenen Webseite hat sich dann auch per Kommentar zu Wort gemeldet, und beklagt, daß keine der von Matt Cutts so löblich hervorgehobenen E-Mails (keine andere Suchmaschine ist so "nett/zuvorkommend/kommunikativ") angekommen ist.

Der Grund: Spamcop hat einige der Google-Mailserver als Spam-Quelle gelistet. Damit wurden diese E-Mails abgewiesen, da sie ja von einer mutmaßlichen Spam-Quelle stammten.
Google sollte stärker darum bemüht sein, nicht in Blacklisten zu landen, als Mail Empfänger hat man ganz schön ins Klo gegriffen, wenn eine so wichtige E-Mail nicht ankommt. (Immerhin kann dies ein Hinweis auf einen möglichen Hack sein, einige verdienen mit Webseiten ihr gesamtes Einkommen)

Als Fazi kann man festhalten, daß man sich bei der Google Webmaster Console anmelden sollte, und regelmäßig den Status der eigenen Seite übrprüfen sollte. Neben "Bestrafungen" kann man dort auch andere wichtige Dinge sehen: Wie gut kann Google die Seite crawlen, kommt es zu Netzwerkproblemen oder vielen 404 Seiten, etc.

Erkenntnisse

25 December 2005

Unglaublich! Ich würde mal sagen der Tag der Erkenntnisse!
Das spannendste vorweg: Ich habe die ganze Zeit ein Phantom gejagt. Meine Java Swing Applikation war zeitweise extrem langsam, ein Bildschirm-Draw dauerte locker 2 Sekunden, und ich konnte die Ursache nicht finden. "nderte ich etwas an Stellen die scheinbar nichts mit dem Swing zu tun hatten, ging es mal flott, dann wieder langsam.
Ich vermutete, daß es an der Art der Hintergrundauslastung des Systems läge - MP3-Player ausgemacht. Langsam.
Webbrowser ausgemacht. Schnell.
Nach dem Telefonieren war es wieder langsam.
Durch Zufall stieß ich dann darauf: Wenn ich in der Eclipse IDE den Quelltext meiner Gui als vorderstes Fenster hatte, so wird alles langsam. Ist die Datei geschlossen oder im Hintergrund, ist alles ok. Aua aua aua.

Hm. Nach einem Neustart von Eclipse ist wieder alles lahm. Auch wenn alle Dateien geschlossen sind. Mist !!!

Dann habe ich noch diese tolle Webseite gefunden: domain-engel.de. Was auch immer die da treiben, offenbar haben die sich Domains "geholt", als deren Registrierung abgelaufen ist. Der dadurch entstandene Effekt: Hatten die Seiten einen guten PageRank (Google Maßeinheit für die Stärke der Verlinkung der Seite, Qualitätsmerkmal), so kann dieser nun verwendet werden, um eigene Inhalte als "wichtig" und "gut;" den Suchmaschinen, insbesondere Google, verkaufen. Praktisch, wenn man bedenkt was es kostet, statt dessen Werbung zu buchen.
Und dann wird man dort noch aufgefordert, eine k.exe herunterzuladen - was auch immer dieses Programm tut. Ich rate jedem dringend davon ab, irgendwelche Software von irgendeiner Webseite herunterzuladen und zu installieren, wenn der Zweck nicht ganz klar dargelegt wird.
Eine kurze Google Suche brachte zu tage, daß der Inhaber der Webseite mit für meine Begriffe sehr dubiosen Machenschaften in Erscheinung getreten ist, so hat seine eigene Homepage zum aktuellen Tag z.B. kein gütiges Impressum (mariodolzer.de) - aber ansonsten tut der gute Mensch sich nicht klein damit selbst mit dem Heise Verlag Streit anzufangen.
Insbesondere die "k.exe" wird in mehreren Foren als Trojaner, Spyware, Adware oder gar Virus gehandelt. Bleibt nur zu hoffen, daß Google bald etwas gegen soetwas unternimmt - ganz einfach z.B. indem der Admin-C der der Domain geprüft wird - ändert er sich und die Inhalte ändern sich ebenfalls in einem zeitlichen Bezug, so sollte Google die Seite neu bewerten.


/
Copyright © 2007, 2008 everflux. Alle Rechte vorbehalten. All rights reserved.